
問題在哪裡?
別人就都沒問題 怎麼就你問題最多??
你怎麼不找找你自己的問題??
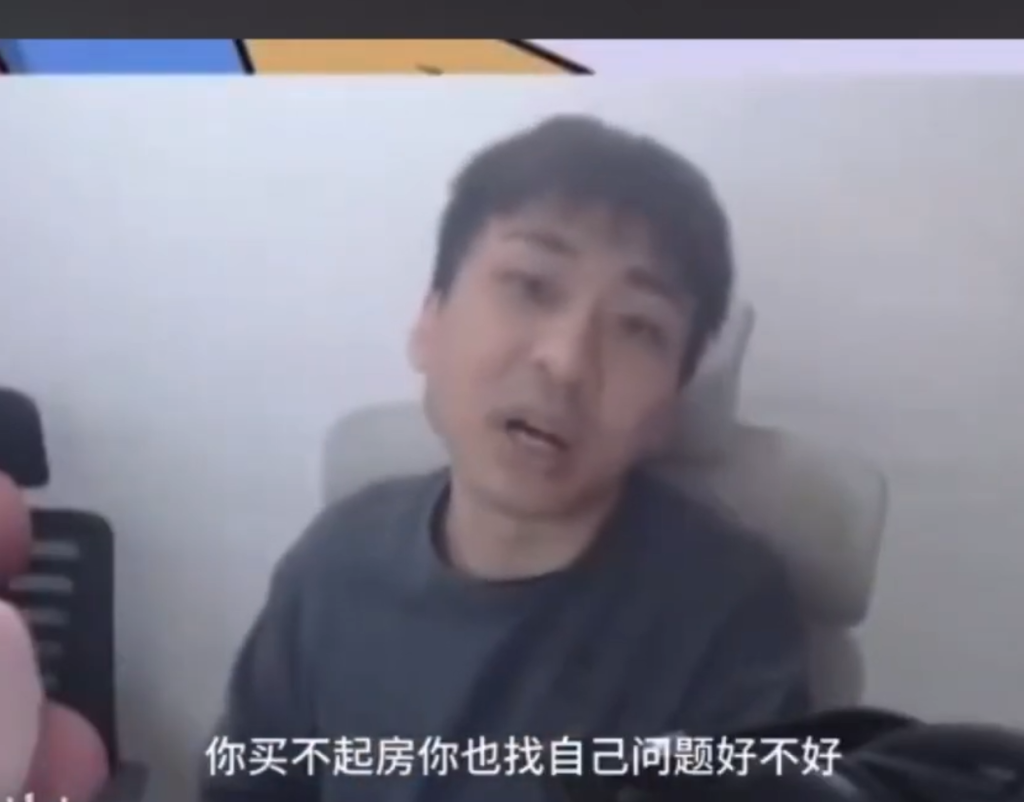 ]
meme source:一起來找找問題吧~
P.S
AI 好厲害 原本還想自己做遊戲 結果現在AI隨便做都比你認真學怎麼做遊戲厲害
哈哈 變成玩法 機制更重要了
完蛋 已經意識到 自己要變成那種 開始厭惡新科技的年紀了
哈哈 阿哈哈
離題了,回到AI slob
2026/09/08 有小更新了 ++了一些技術細節
前兩天我們都在看 native FWT。
Day 16 看 single-block:資料留在 register、warp shuffle、shared memory swizzle。
Day 17 看 large-N:一個 block 放不下,就用 Kronecker split 做 multi-pass。
今天回到一開始那個誘惑:
Hadamard matrix 只有 +1 / -1,
那是不是很適合 Tensor Core?
直覺上是。
實作上很麻煩。
而且更重要的是:就算實作出來,也不一定比較快。
(這真的蠻哭的 就算把形狀改好 還是很靠北)
Tensor Core 的 MMA 指令喜歡固定形狀的 tile。
例如 INT8 path 會看到這種指令:
mma.sync.aligned.m16n8k32.row.col.s32.s8.s8.s32
意思是:拿 INT8 的 A tile 和 B tile 做矩陣乘法,累積到 INT32 accumulator。
這對 GEMM 很自然。
但 FWT 的原始形狀不是 GEMM。
FWT 是 butterfly network:
stage 0: local pair add/sub
stage 1: stride 2 add/sub
stage 2: stride 4 add/sub
...
所以要用 Tensor Core,就必須先把一段 Hadamard transform 改寫成 block GEMM。
這就是成本開始出現的地方。
Hadamard 還是那個 Kronecker:
H_N = H_a ⊗ H_b
N=14 可以切成 7 + 7。H_7 是 128 × 128、元素只有 ±1 的小矩陣。於是 H_{14} x 變成:
把長度 2^14 的向量看成 128 × 128 的矩陣 X

Z = X  H_7      // 右邊乘一次
Y = H_7 Z       // 左邊再乘一次;中間通常要 transpose / reshape
H_7 不必真的存成矩陣。(i, j) 那個 ±1 就是 popcount(i & j) 的奇偶:
int par = __popcll((uint32_t)gk & (uint32_t)gn) & 1;
int8_t val = par ? -1 : 1;
這點很誘人:Hadamard 那一側幾乎免費,可以在 kernel 裡現算,塞進 MMA 的 B fragment。
聽起來我們賺到了。問題在另外三筆帳:
1. 要把 X 排成 Tensor Core 喜歡的 tile
2. 兩次 GEMM 中間要 transpose
3. 如果走 INT8,還要把浮點 input 變成 residual
FWT 原本每一層只做一次加減。現在為了用 MMA,多了 layout、轉置、轉換。對 GEMM 來說,這些固定成本可以被很大的 K 攤掉。對 H_7 這種 K=128 的小塊,不一定攤得掉。
先看比較單純的一條:不用 Ozaki,讓 Tensor Core 直接吃浮點。
實作上大致是:
把 state 看成 128 × 128
用 cuBLAS / TF32 做 Z = X H_7
把內層兩個維度 transpose
再做 Y = H_7 Z
連 dense 的 H_7 都可以真的建出來再乘。那顆 transpose kernel 長得很普通:
__global__ void transpose_inner_dims(const float* in, float* out, int B, int D) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < B * D * D) {
        int b = idx / (D * D);
        int rem = idx % (D * D);
        int i = rem / D;
        int j = rem % D;
        out[b * D * D + j * D + i] = in[idx];
    }
}
D=128 時,這就是對每個 batch 做一次 128 × 128 轉置。FWT 的加減法幾乎是免費的;這次轉置卻是不連續的 global memory 寫出。L2 很容易被打穿。
把 transpose fuse 進 MMA kernel 是對的方向,因為丟回 Python 或另開一顆 kernel 會更傷。但 fuse 掉以後,你還是多做了「為了 MMA 而存在的 layout conversion」。FWT 本身不需要這一步。
同一組大約 N=14 的對打:
native FP32          約  40 us
TF32 + transpose     約 380 us
慢大約九倍。這裡沒有 CRT,沒有多 modulus。慢的就是餵資料。
Hadamard 那一側放進 INT8 幾乎是免費的,+1 / -1 本來就適合 int8_t。問題在 state vector。
input 是 FP32 或 FP64,不能直接丟進 mma.sync 的 s8 fragment。前面 GEMM 系列那套又出現了:
v
 → 乘一個 scale
 → 對 p = 127, 113, 109, 107 取餘數
 → 折回有號 int8
 → 每個 modulus 做一次 MMA
 → CRT / scaling 拼回來
kernel 裡這段長得很直白。每個 thread 讀一個 float,當場切成四個 residual,寫進 shared memory 的四個平面:
float v = X[(size_t)gr * k + gc];
int32_t sign = (v > 0.0f) ? 1 : -1;
uint32_t u = __float2uint_rn(fabs(v) * scale_factor);

smem_X[0 * 4096 + smem_idx] = fold(u % 127, sign, 127);
smem_X[1 * 4096 + smem_idx] = fold(u % 113, sign, 113);
smem_X[2 * 4096 + smem_idx] = fold(u % 109, sign, 109);
smem_X[3 * 4096 + smem_idx] = fold(u % 107, sign, 107);
ldmatrix 要求 16-byte 對齊,所以 X 的 shared memory stride 不能隨便設。32 會撞 bank,後來改成 48,讓 ldmatrix 和 bank 兩邊都過關。這跟 Day 9 GEMM kernel 是同一類坑,只是這次 K 小很多。
然後才是 MMA:
mma.sync.aligned.m16n8k32.row.col.s32.s8.s8.s32
B 那一側不必載入真正的 Hadamard 矩陣,可以用前面的 popcount 現算 ±1 再 pack。A 那一側卻已經付完 conversion 的錢。
如果這是 M=N=K=4096 的 GEMM,INT8 MMA 會做很多有效乘加,conversion 有機會被攤掉。這裡 K 只有 128 這個 Hadamard block 的寬度。FWT 每一層又只是一次加減。於是出現一個很尷尬的不等式:
MMA 省下的時間 ? conversion + layout + transpose + CRT 的時間
Tensor Core 的峰值很漂亮。FWT 的 arithmetic intensity 卻非常低。
N=14、batch 對應大約 16 MB 的 state 時,真正的運算是:
每個 element、每一層一次 add 和一次 sub
層數 = 14
加減法在 4060 上幾乎是免費的。時間會被「把 16 MB 搬幾次」主導。native path 的目標是:進 GPU 一次、在 register / warp 裡換位置、寫出去一次。
Tensor Core path 為了把問題變成 GEMM,通常至少還要:
把 X 排成 tile          (讀)
做完第一次小 GEMM       (寫)
transpose               (讀 + 寫)
做完第二次小 GEMM       (讀 + 寫)
中間任何一次不連續 access,GPU 都可能為了少量有效資料搬很多 sector。峰值 TFLOPS 完全幫不上忙。
所以這題不能問 Tensor Core 有多少算力。要問:用了它之後,多了多少 bytes。
這三組不是跟明天 Dao 那張表同一個 harness,但足以說明寫法差在哪。大約都是 N=14 這個量級:
1. 把 H 當真的 dense GEMM 來乘
   native FP64     約     600 us
   dense Ozaki     約 314,000 us
這不是小幅輸。是把 O(N 2^N) 的 FWT 改回 O(2^N 2^N) 的矩陣乘。方向錯了。
2. 用 Kronecker 切成 128 × 128 的小塊再走 Ozaki
   native FP64     約 600 us
   radix-128 Ozaki 約 900 us
結構有用,從慢五百倍拉回慢 1.5 倍。還是沒贏。CRT 和 conversion 對這麼便宜的運算仍然太重。
3. 拿掉 CRT,只留 TF32 + transpose
   native FP32     約  40 us
   TF32 + transpose 約 380 us
問題不只是 Ozaki。就算沒有 residual,光是轉置和 layout 就可能比 butterfly 貴一個數量級。
不是說 Tensor Core 對量子模擬沒用。是 FWT 這個 operator 太特殊。
如果換成比較 dense 的局部 gate、比較大的 block operator、或真的有足夠 accumulation 的 tensor contraction,情況會不同。那時候 layout 轉換有機會被 MMA 攤掉,前面 GEMM 系列的工具才回到主場。
FWT 剛好反過來:每層只有加減,不該把 Hadamard 矩陣生出來,也不該為了 MMA 多做一輪轉置。
所以今天的結論不是「不要用 Tensor Core」,而是:
不要為了用 Tensor Core,把一個很低 arithmetic intensity 的問題,改寫成更重的問題。
下一篇把比較標的放到同一張桌上。native、Dao、Tensor Core,到底哪些數字可以比,哪些其實在比不同的事情。
主委加碼:
寫個程式 讀個資工
寫一個月 阿 AI又更新了
別人怎麼都百萬年薪 隨便AI指令一下就有了
要你幹嘛?
沒有工作怎麼不找找自己問題?
阿叫AI做就好了啊 那麼厲害 都給AI做就好啦
找自己問題
你怎麼不找找你的問題
你怎麼不找找山姆奧特曼的問題?
是我發明AI的嗎?
是我讓你失業的嗎?
你告訴我 怎麼打?(代碼)
GPT又發布新版本拉
然後黃仁薰就在那邊
阿哈哈哈哈 未來不需要工程師 大家應該去當水電工
然後中國又出個什麼迪譜吸客 v4pro v4 破麻 v5 v6.7 v8.7
阿啊啊啊 v8964
然後瑪斯克又在那邊 阿未來人類不用工作
nm了個臭b的 你告訴我怎麼贏? (影片原話)
阿?
你排一群靠AI販賣焦慮衝股票的給我
怎麼贏?
被玩到死 內捲到死
然後沒工作了
親戚就來一句
哎呀 你怎麼不多多找找自己問題呢?
ni ma der
meme source:原影片~
(純粹搞搞抽象 請勿當真 也請尊重每位媽媽跟女性 peace and love)
已閱讀 6 1 2 5 字


 iThome鐵人賽
 看影片追技術